Независимая проверка системы, которая отвечает на отзывы покупателей: разбор кода и правил, замер качества ответов на живой выборке и вердикт — дорабатывать или переписывать — с планом работ
Компания KEO продает товары на Wildberries, и отзывы покупателей остаются одним из главных каналов общения. Для ответов на них внешний подрядчик разработал автономную систему: в ней генерируются черновики ответов, которые операторы проверяют и правят, а в части категорий ответы отправляются автоматически.
Ответ на отзыв влияет на репутацию карточки, а ошибка вроде признания вины без доказательств или лишнего обещания стоит денег. Поэтому ответы должны быть точными и не содержать лишнего.
Операторы все чаще переписывали черновики, а доля автоматизации два месяца не росла. Правки операторов нигде не фиксировались, поэтому оставалось неизвестным, какие правила повлияли на текст и чем операторов не устраивали черновики. Одни и те же ошибки возвращались, хотя систему уже «обучали» на этих примерах.
Требовалась независимая оценка, которая ответит на два вопроса: дорабатывать систему или переписывать ее и как передать контроль качества операторам.
Выборку из 50 негативных отзывов мы вручную разметили по трем категориям: без изменений, мелкие правки, существенно переписано. Данные псевдонимизированы, персональных данных в выборке нет.
Мы определили, как передать контроль качества операторам, и выделили для него отдельную волну доработок.
Мы изучили код, правила и базу знаний на копии системы: боевые данные не выгружались. Для каждой правки определили причину по таксономии клиента и нашли, что именно учит систему писать лишнее.
Руководитель получил отчет без терминов, разработчик — с привязкой к файлам и строкам. В отчете есть карта системы, находки по приоритетам, вердикт по срокам и деньгам и план доработок.
Разберем аудит по шагам: что проверяется на каждом этапе и что получает клиент.
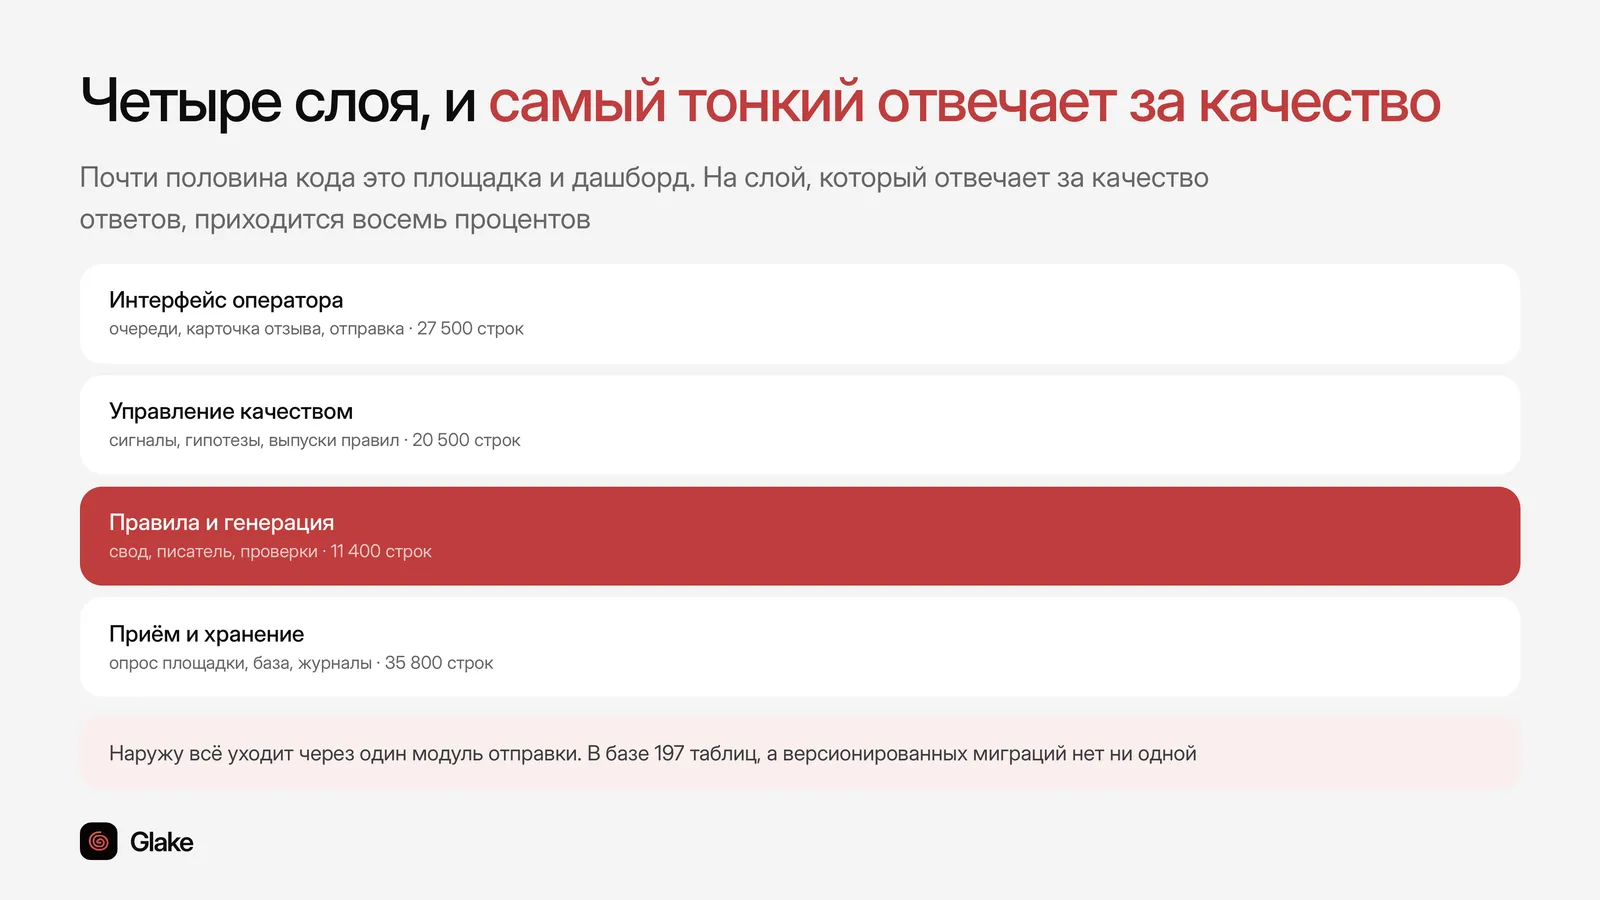
Сначала мы выясняем, как устроена система на самом деле. Она оказалась конвейером, а не автономным ИИ-агентом: он последовательно выполняет прием отзыва, нормализацию, анализ моделью, выбор правил кодом, написание черновика, проверки и отправку. Модель вызывается только в двух местах, а остальные этапы выполняет обычный код. Ответ на Wildberries отправляется единственным путем.
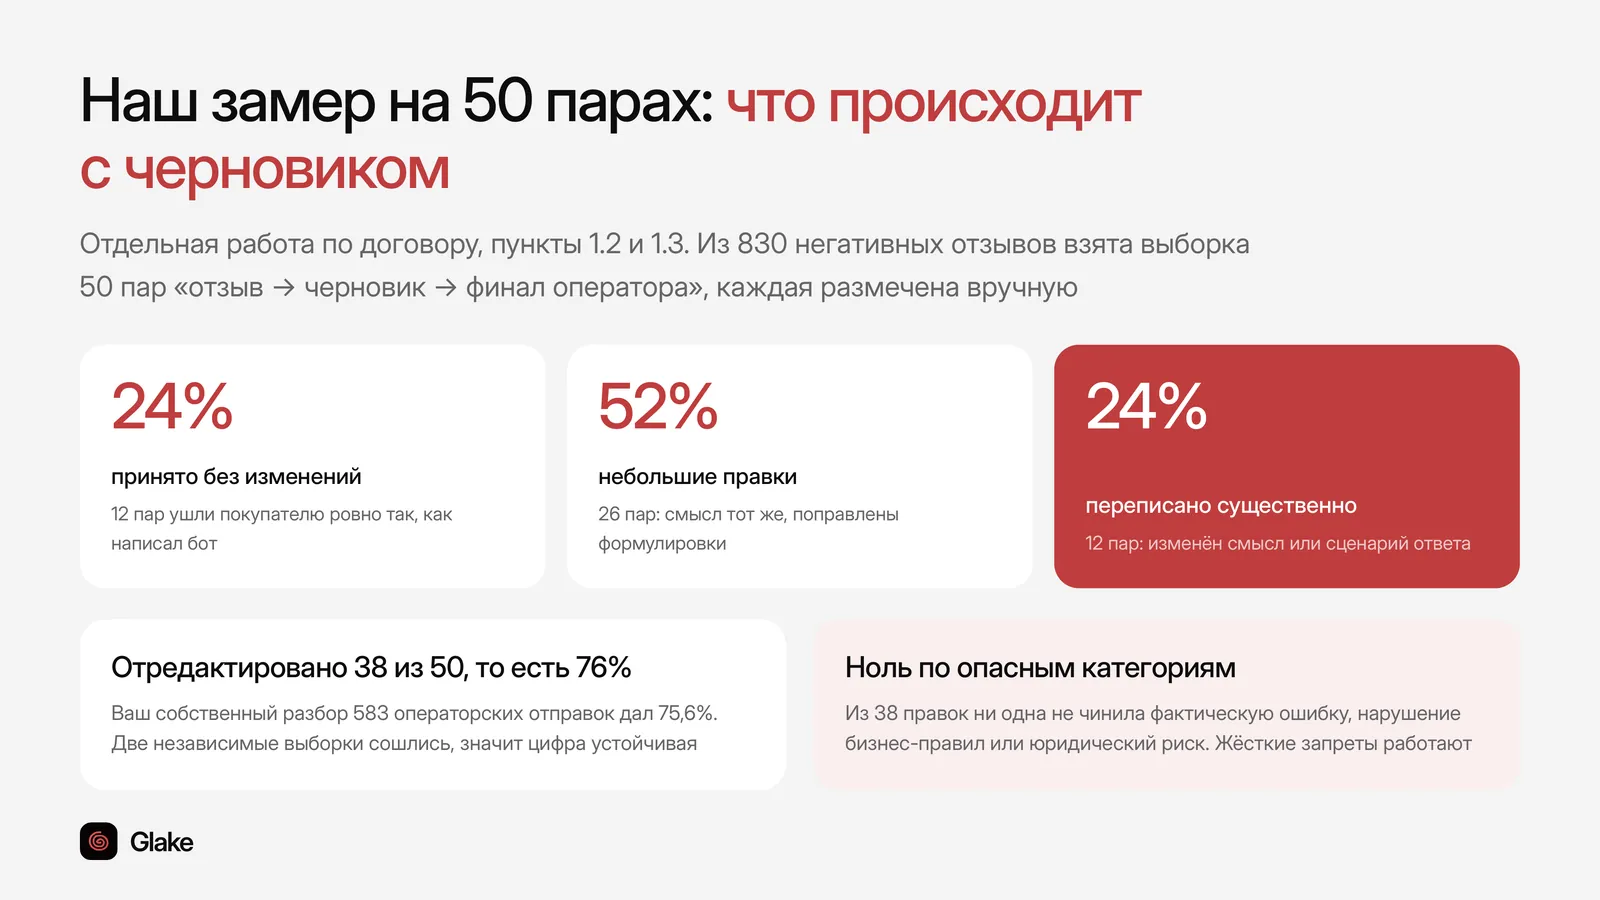
Затем мы измеряем качество на живых данных. В выборке 24% ответов отправлены без правок, в 52% внесены мелкие правки, а 24% переписаны существенно. Всего правки внесены в 76% ответов. Статистика из базы системы подтверждает результат: из 583 ответов, отправленных операторами, 441 был изменен.
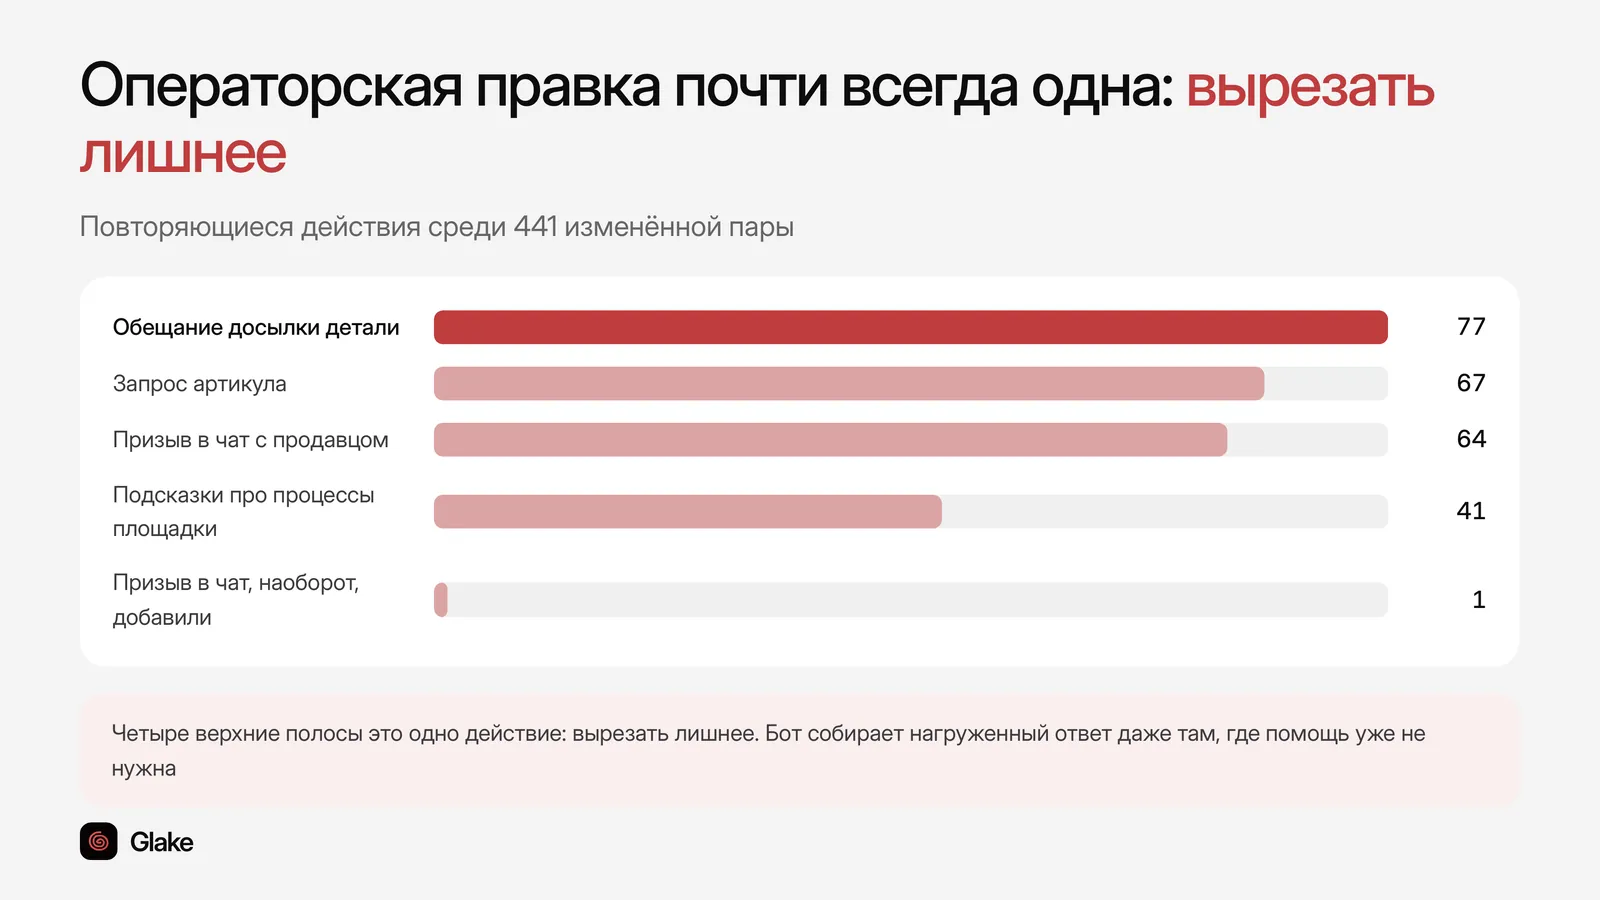
Разметка показывает причины правок. Чаще всего ими оказываются тон (39,5%) и лишняя эскалация, например отсылка в чат продавца (21,1%). Реже встречаются неверный сценарий и неверный следующий шаг (по 13,2%), непонимание контекста (7,9%) и выдуманные детали (5,3%). Юридических и фактических ошибок нет: жесткие запреты в системе срабатывают.
В итоге мы называем главную причину слабых ответов и показываем, где она скрыта: примеры в правилах учат перегруженному ответу. На встрече мы показываем презентацию и обсуждаем дальнейшие шаги.
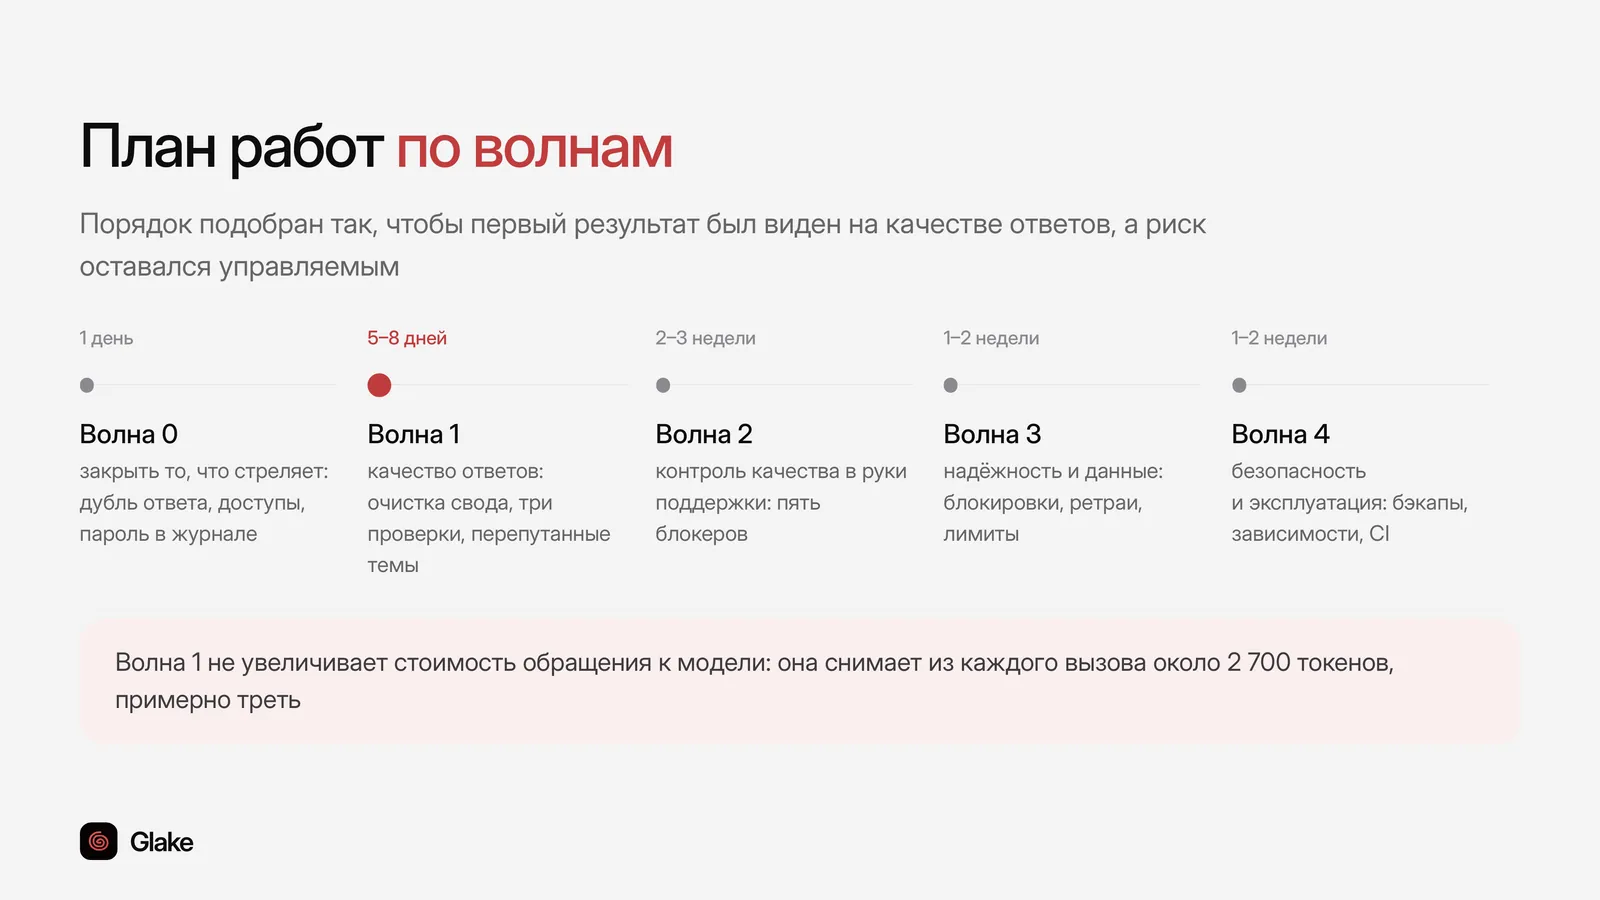
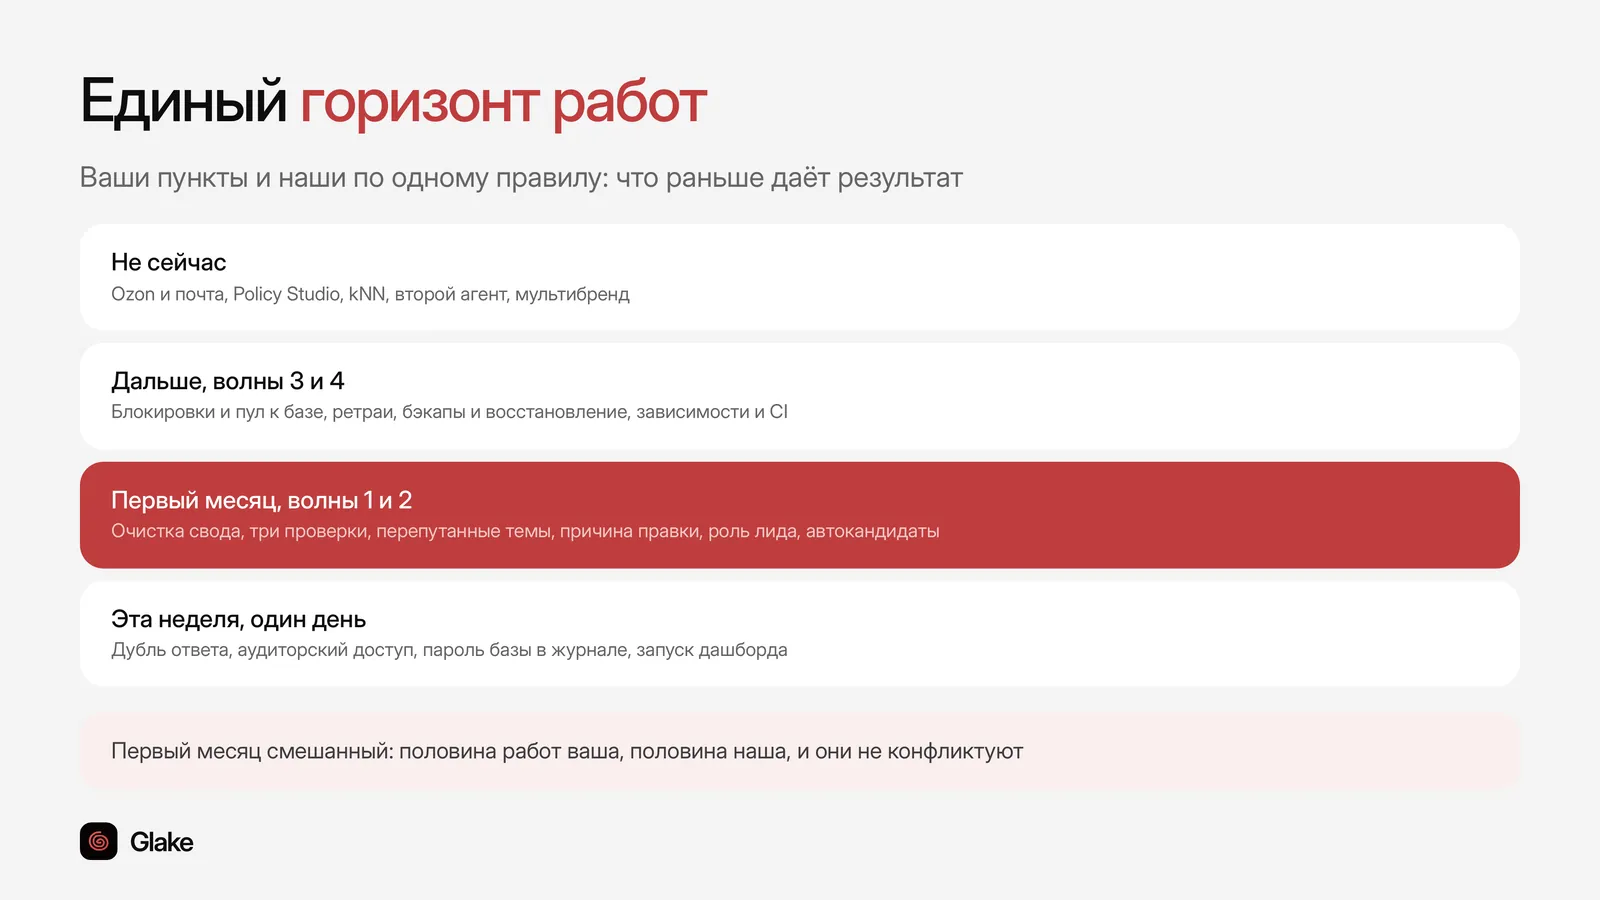
Также: Дашборд оператора — проверка черновиков · VPS с защитой на уровне системы — запуск и перезапуск служб · независимый сторож — контроль работы
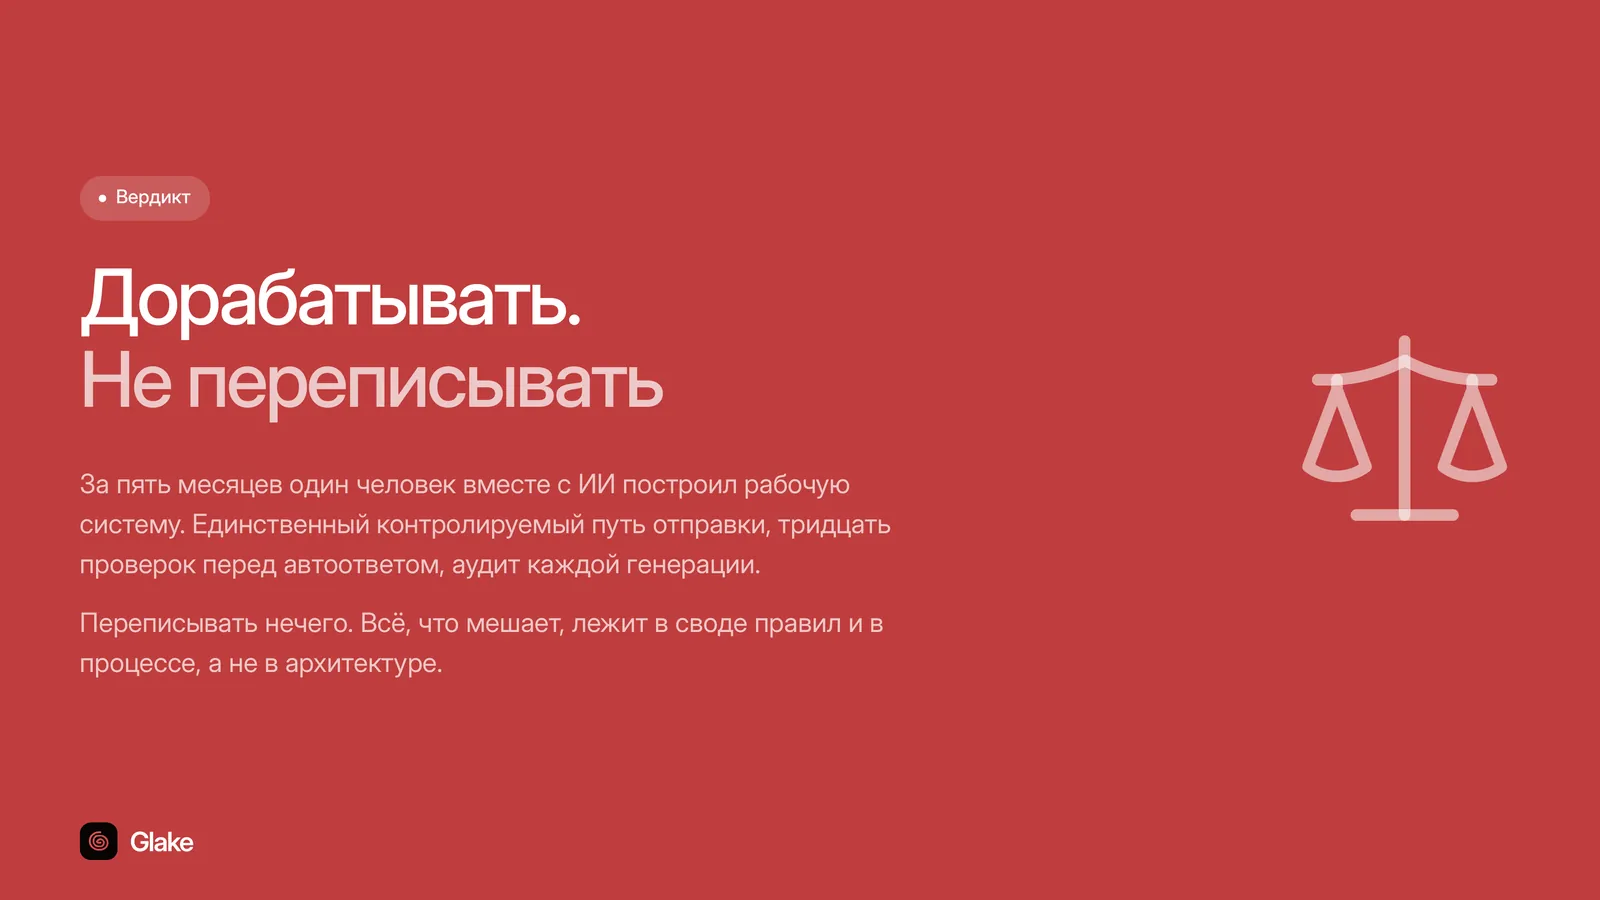
Клиент получил независимый вердикт: систему стоит дорабатывать, а не переписывать. Аудит показал, где теряется качество ответов и в каком порядке исправлять проблемы.
Такой аудит подходит для любых AI-систем: чат-ботов, ассистентов, внутренних сервисов и автоматизаций. Он нужен компаниям, которые хотят понять, насколько системе можно доверять и что исправлять в первую очередь.
Делаем такие решения под задачу: AI-продукты под ключ, AI-агенты и автоматизация, интеграции и данные.
Услуги GlakeОставьте заявку — обсудим вашу задачу и покажем, как применить это у вас
Мы используем cookies и Яндекс.Метрику, чтобы улучшать сайт. Подробнее