Система читает сканы УПД, счетов-фактур и накладных, вносит реквизиты в Excel-реестр и помечает поля, которые не удалось распознать с высокой точностью. Система развернута на сервере компании, документы не передаются во внешние сервисы
Corestone с 2013 года помогает производственным компаниям включать продукцию в реестр Минпромторга. Включение в реестр подтверждает российское происхождение товара и открывает доступ к госзакупкам и льготам. Проектов у компании много, и по каждому накапливается большой объем первичной бухгалтерии.
Первичные документы — это УПД, счета-фактуры и накладные, которыми оформляется каждая поставка. Бухгалтерия сводит их в реестры с реквизитами: номером, датой, поставщиком, покупателем, основанием, суммой, печатями, признаками электронного документооборота и таблицей позиций. Документы приходят сканами разного качества.
Ручное внесение занимало много времени, а при большом количестве документов ошибиться в сумме, номере или дате было легко.
Было и еще одно условие: документы чувствительные, поэтому отправлять их во внешние облачные сервисы нельзя.
Поэтому было важно, чтобы реестр формировался автоматически, а вся обработка проходила внутри инфраструктуры компании.
Сотрудник указывает папку в хранилище компании, а система распознает документы и формирует Excel-реестр: скачивать или загружать файлы отдельно не приходится. Склеенные в один файл документы разделяются и разбираются по отдельности.
Распознавание идет в два уровня, поэтому результат остается точным даже на повернутых и блеклых сканах. Поля, которые не удалось распознать, помечаются, а не подставляются наугад.
Система развернута на сервере компании, поэтому документы не передаются во внешние облачные сервисы.
Разберем по шагам, как проходит работа сотрудника: от входа в приложение до готового реестра.
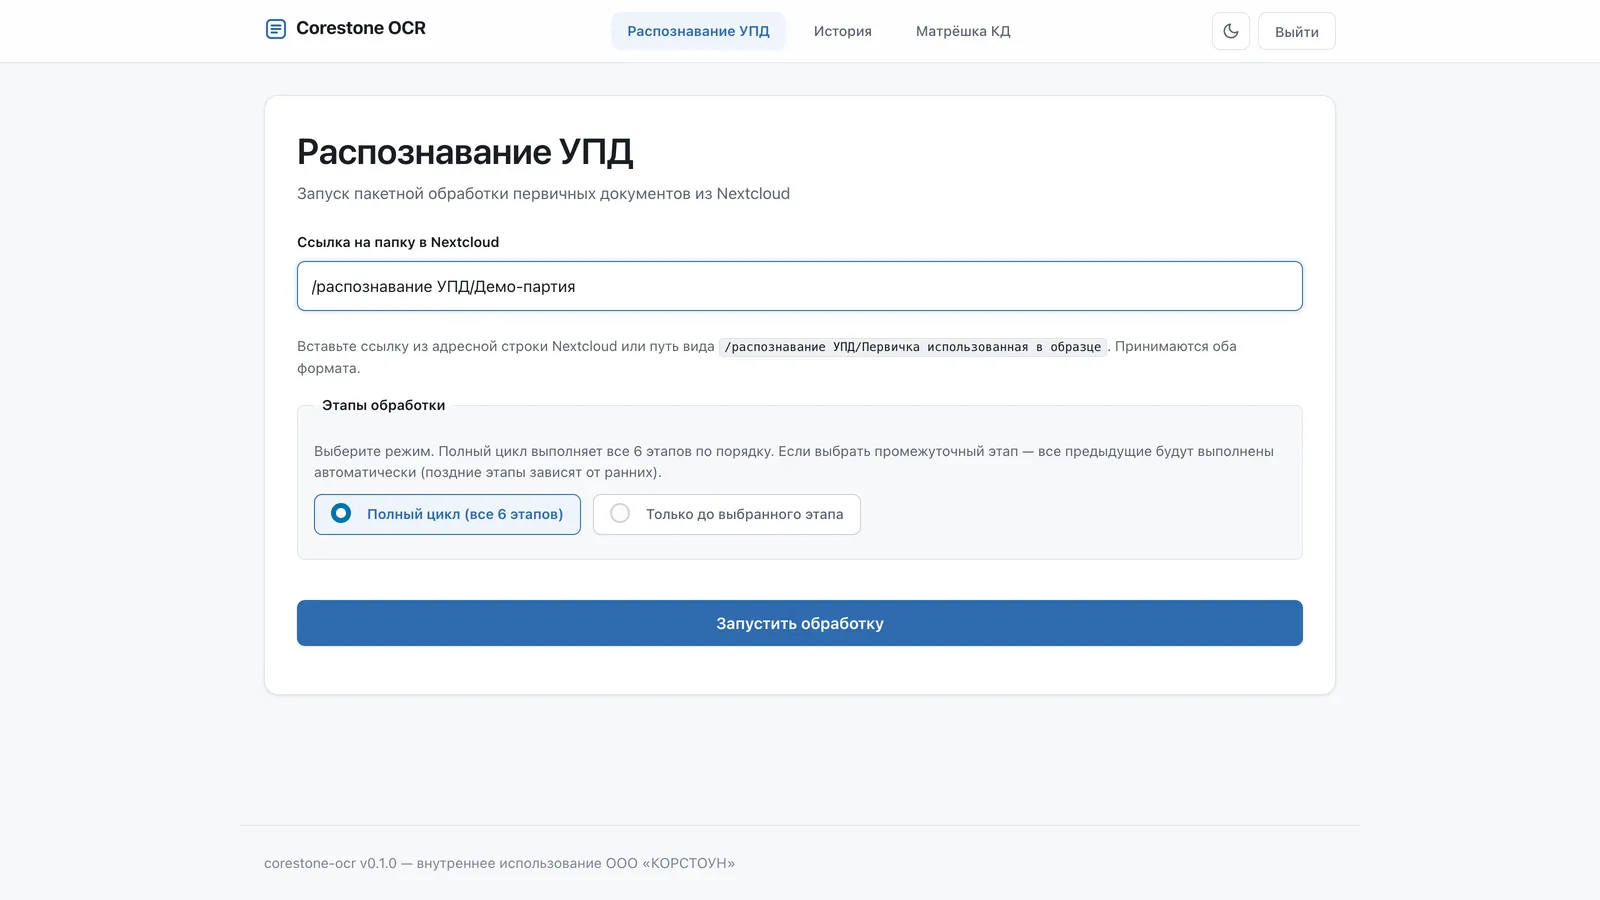
Сотрудник открывает приложение в браузере и входит по логину и паролю. Права доступа зависят от роли: администратор видит все процессы, обычный пользователь — только свои. В разделе «Распознавание УПД» сотрудник вставляет ссылку на папку с документами в хранилище, выбирает режим обработки и нажимает «Запустить обработку».
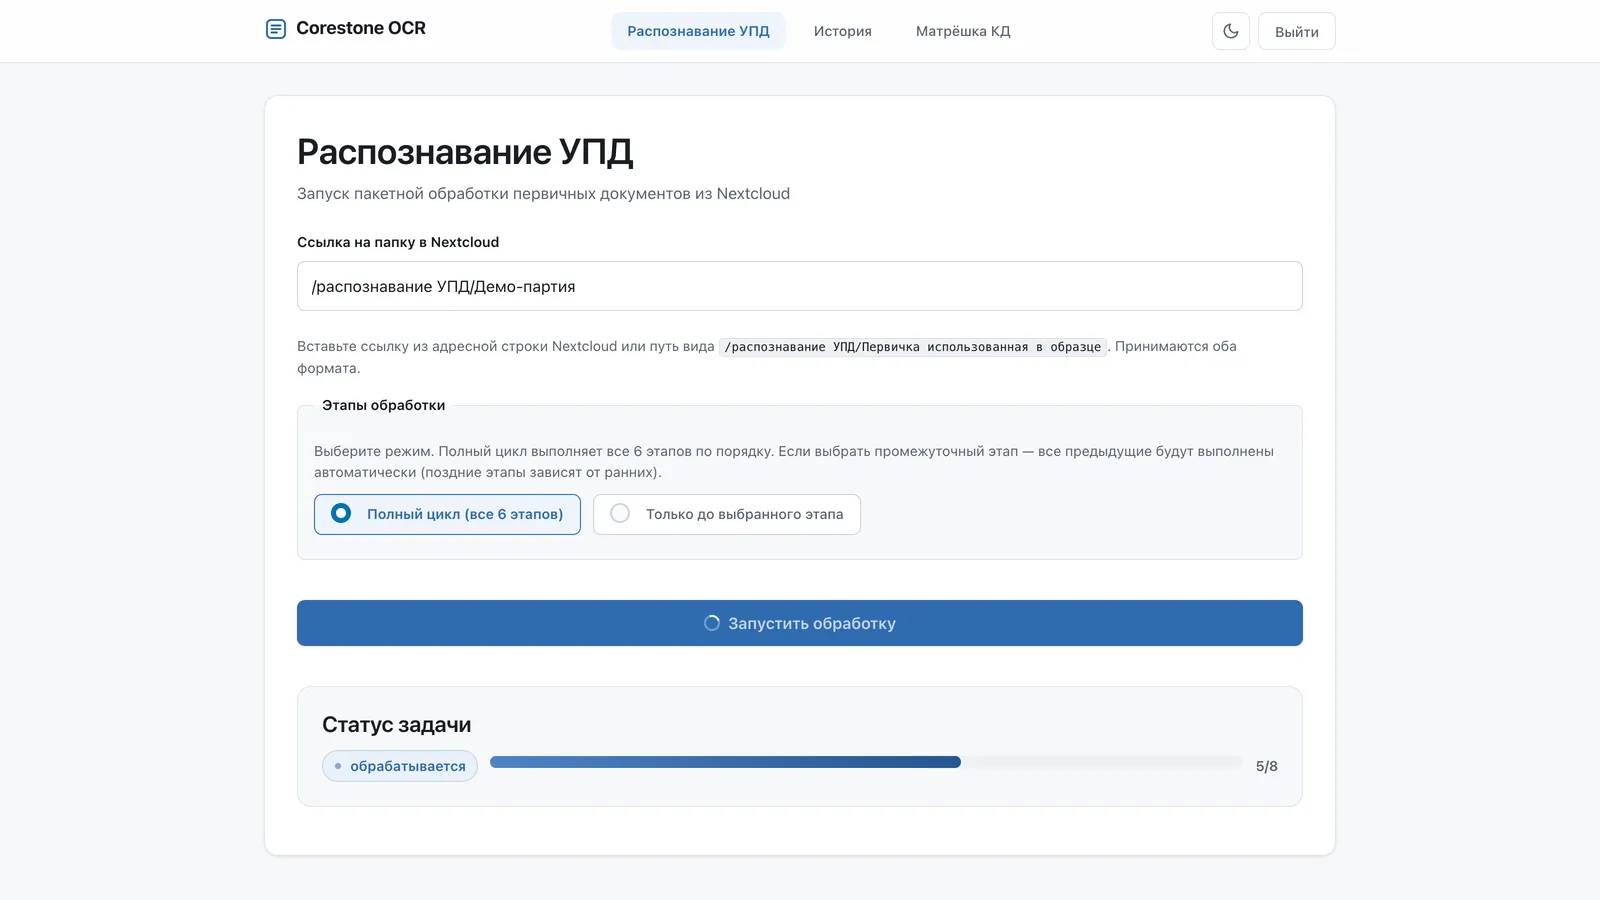
Система скачивает документы из хранилища и обрабатывает их по одному. На экране виден статус: сколько документов в папке и сколько из них уже обработано. Каждый документ последовательно проходит распознавание, определение типа и поиск печатей.
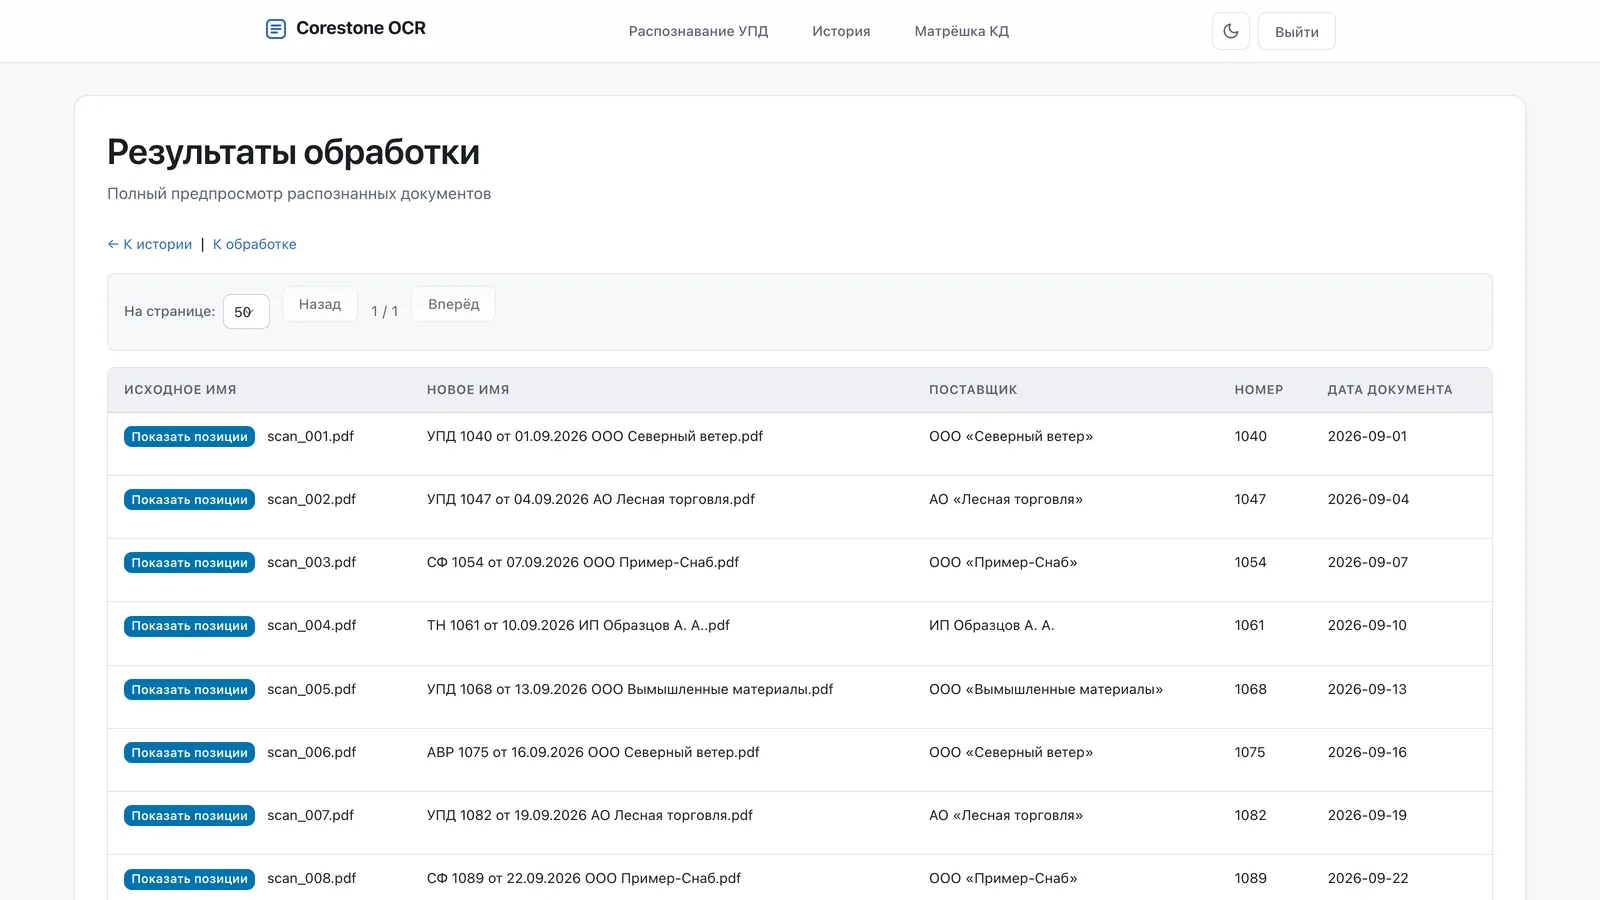
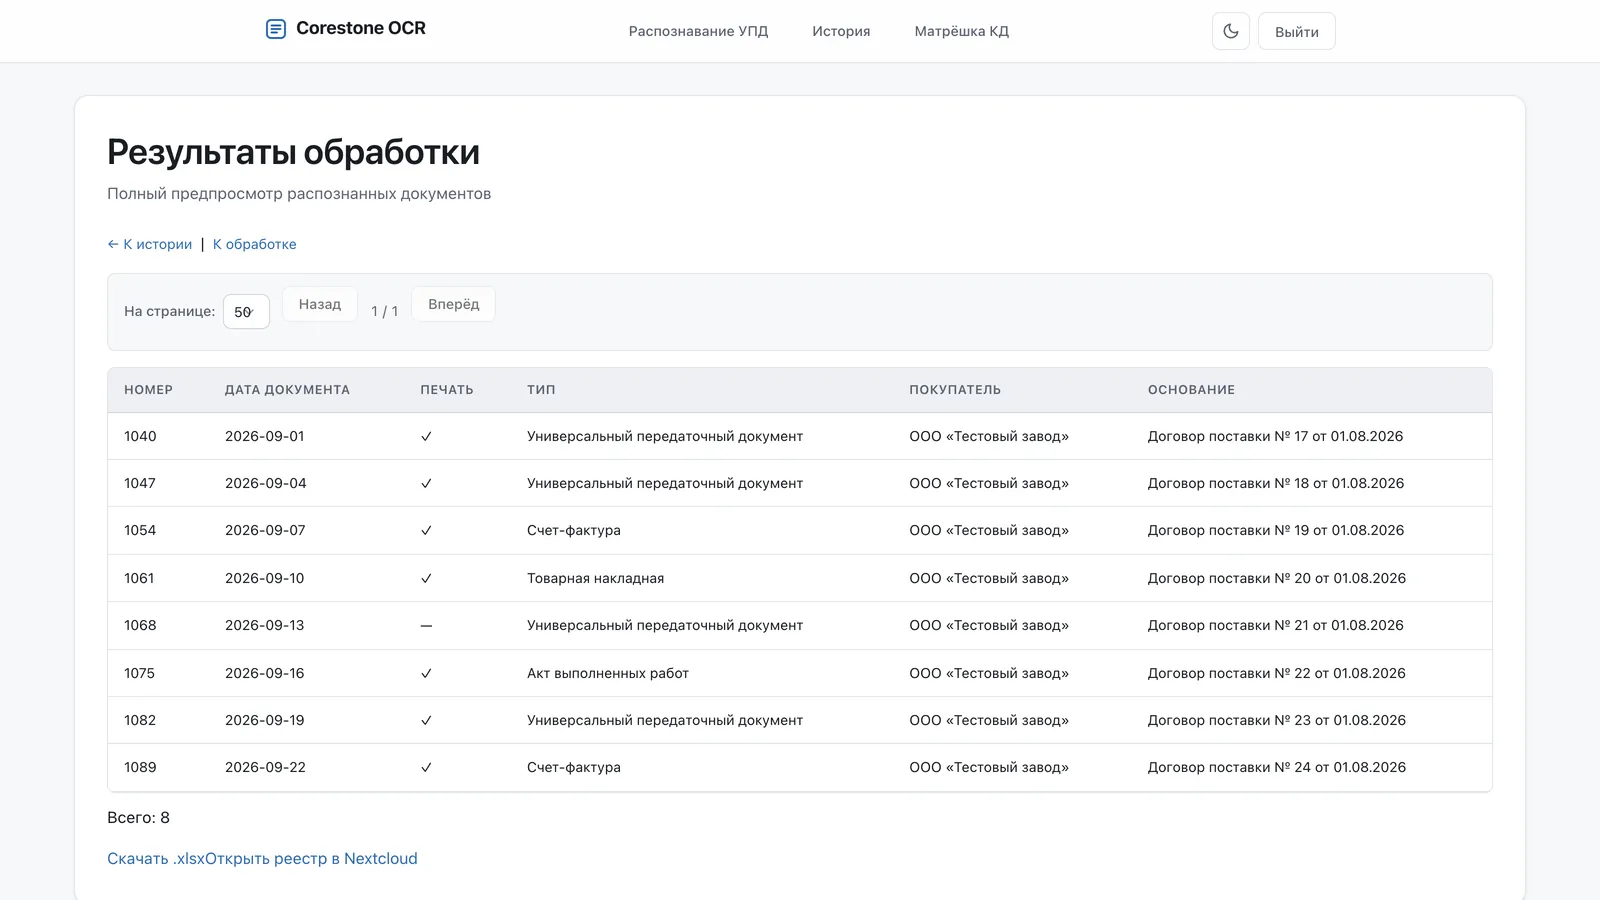
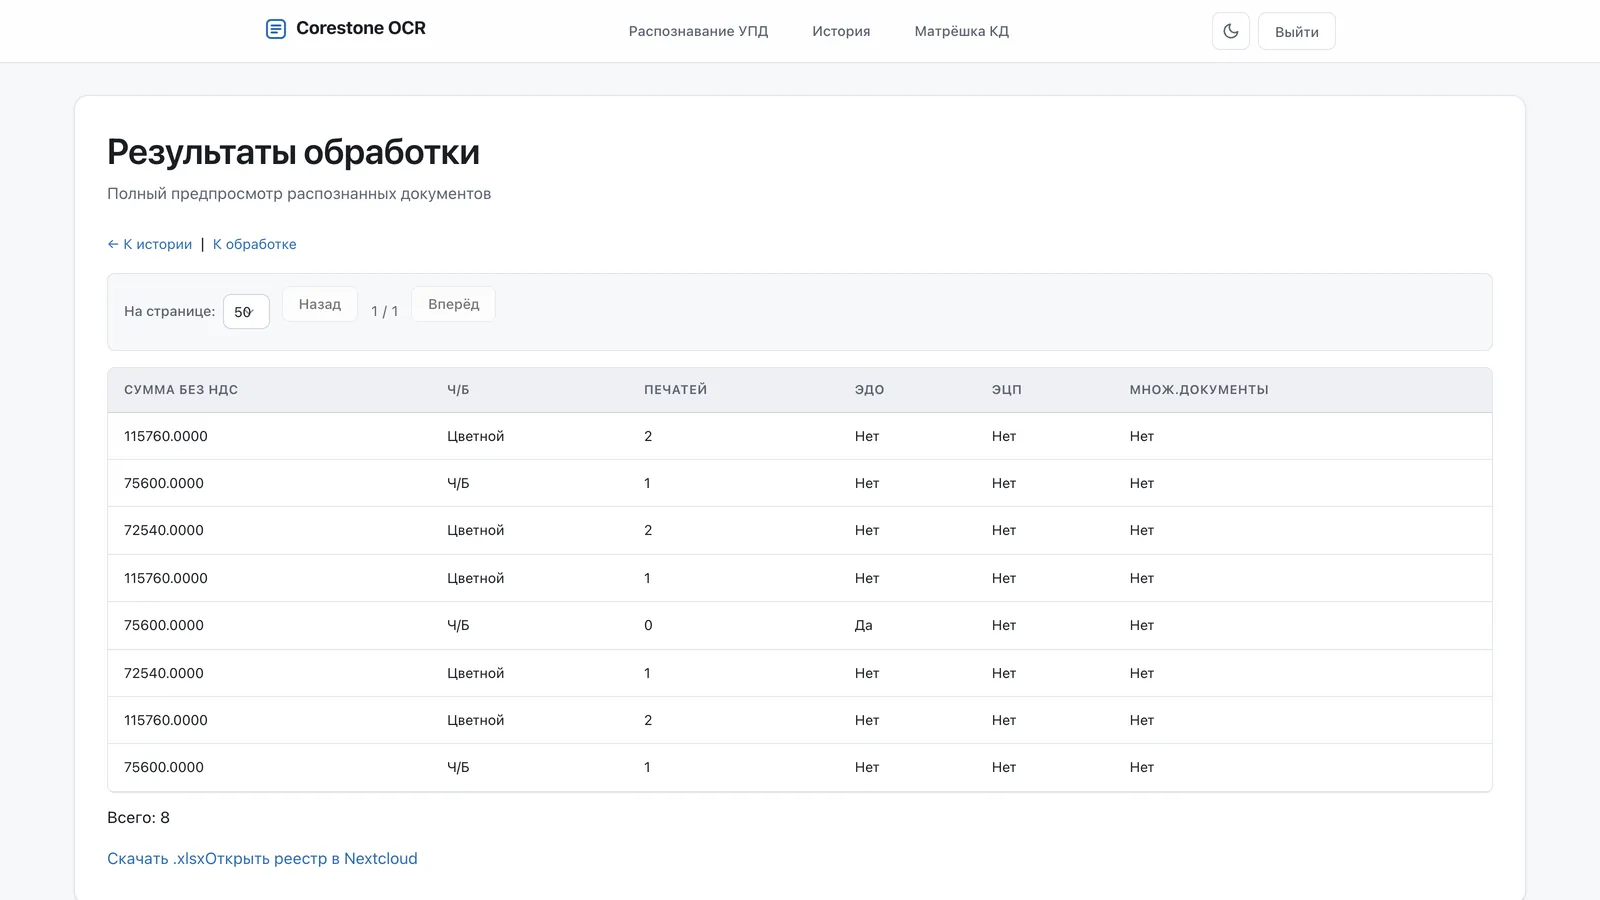
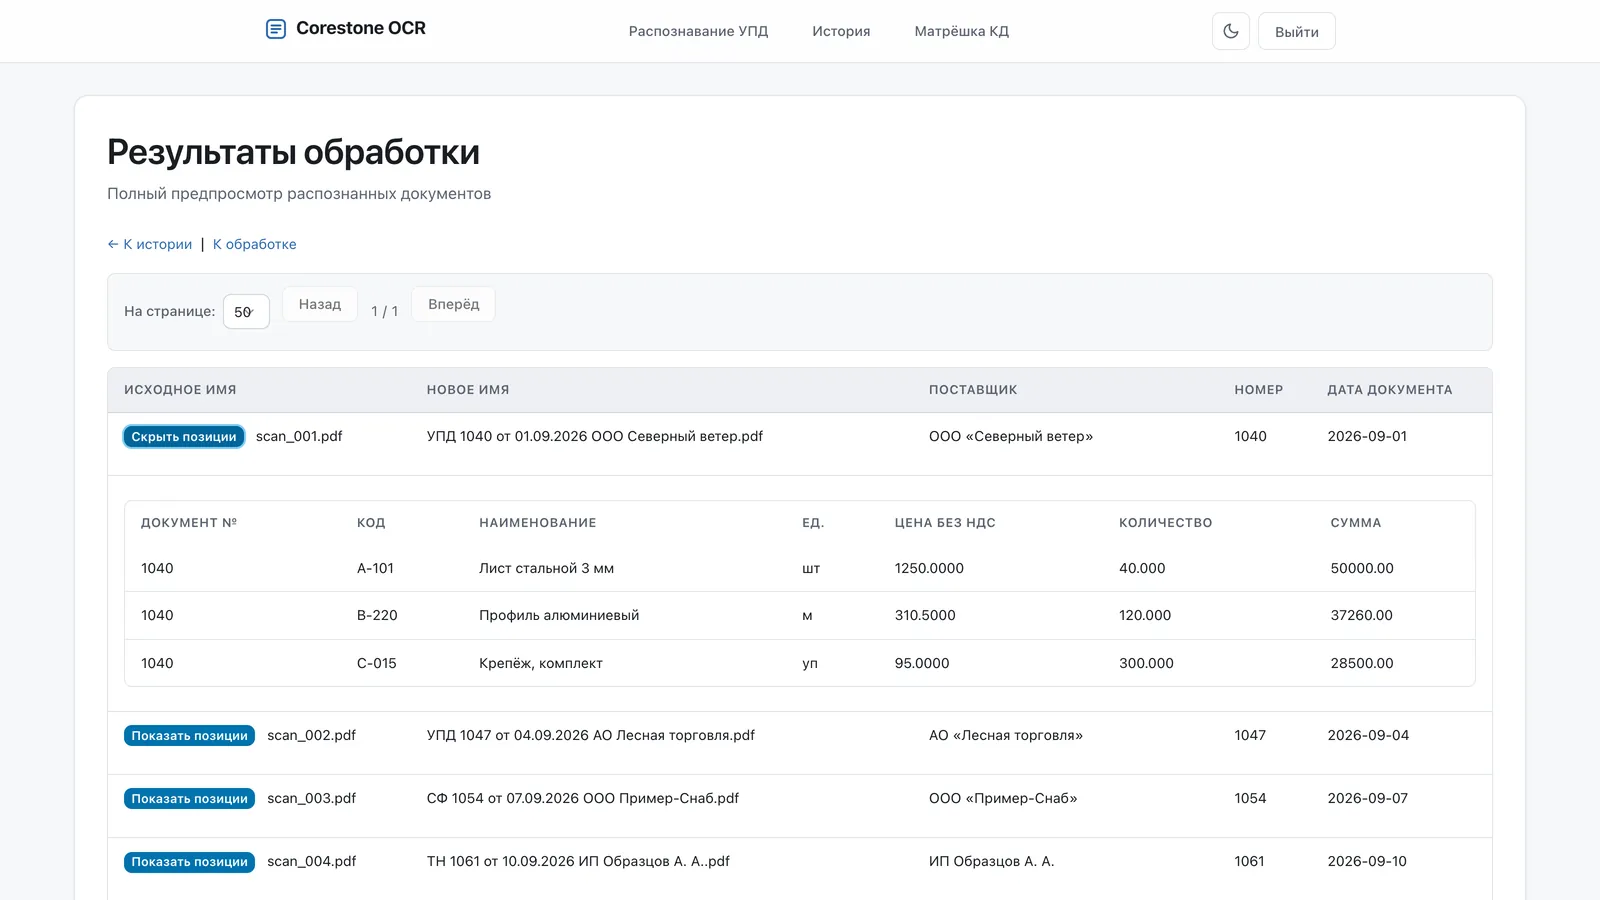
После завершения обработки открывается предпросмотр всех распознанных документов. Таблица листается вправо: по каждому документу видны тип, номер, дата, поставщик, покупатель, основание, сумма, печати, электронные подписи и позиции.
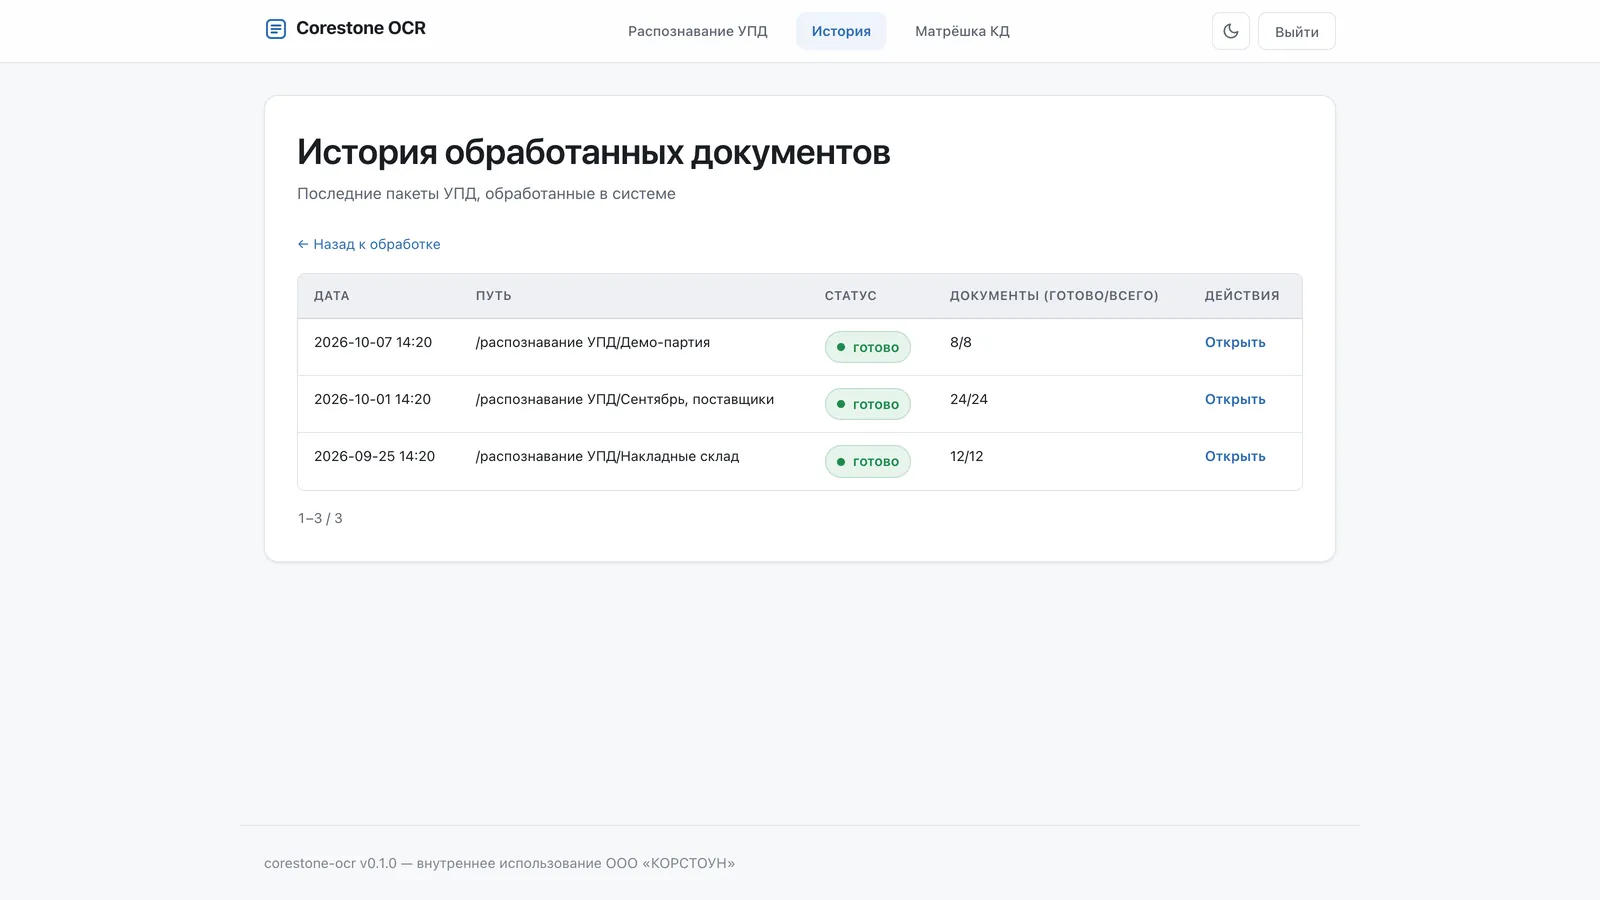
Реестр из предпросмотра выгружается в Excel и сохраняется в папку результатов в хранилище, рядом с переименованными документами: названия строятся по шаблону компании. В разделе «История» хранятся все прошлые запуски со ссылками на результаты, поэтому к любой обработанной партии можно вернуться.
Также: SQLite — история запусков · openpyxl — формирование Excel-реестра
Бухгалтерия обрабатывает сотни документов без ручного ввода, а чувствительные данные остаются внутри компании.
Аналогичные решения подойдут тем, чьи сотрудники переписывают данные из документов в таблицы или системы, а документы нельзя передавать за пределы компании.
Делаем такие решения под задачу: AI-продукты под ключ, AI-агенты и автоматизация, интеграции и данные.
Услуги GlakeОставьте заявку — обсудим вашу задачу и покажем, как применить это у вас
Мы используем cookies и Яндекс.Метрику, чтобы улучшать сайт. Подробнее